Открываете вашсайт.ru/robots.txt - файл есть, хотя вы его точно не создавали. Или наоборот: правите правила через Yoast SEO, сохраняете, а на сайте ничего не меняется. Оба случая - нормальное поведение WordPress, если знать, как оно устроено. Если не уверены, точно ли у вас WordPress - сначала определите CMS сайта: для других систем шаги отличаются.
Можно начать с бесплатной проверки домена: она покажет, что реально отдаёт ваш сайт ботам.
Что такое robots.txt и зачем он WordPress
Файл первым делом запрашивается любым уважающим себя краулером - Googlebot, Яндекс.Роботом, ИИ-ботами вроде GPTBot. Формат простой: строка User-agent называет робота, к которому относятся правила ниже, Disallow и Allow разрешают или запрещают конкретные пути.
Важная оговорка сразу, пока не начали настраивать: Яндекс официально предупреждает - «Ограниченные в robots.txt страницы могут участвовать в поиске Яндекса». Disallow снижает шанс, что робот полезет в раздел, но не гарантирует исключения из индекса. Для реального удаления уже проиндексированной страницы нужен noindex в коде страницы или HTTP-заголовок X-Robots-Tag - служебная инструкция в ответе сервера, которая прямо говорит роботу не включать страницу в поиск, в отличие от robots.txt, который лишь просит не заходить туда при обходе. Проверить, что реально попало в индекс, можно отдельно - через проверку индексации.
Где находится robots.txt в WordPress
вашсайт.ru/robots.txt всё равно откроется - WordPress генерирует его на лету функцией do_robots(). Как только в корне сайта, там же, где wp-config.php, появляется настоящий файл, виртуальная генерация выключается насовсем, и сервер начинает отдавать именно его - без предупреждения, и вернуть прежнее поведение можно только одним способом: удалить файл.
Виртуальный файл по умолчанию выглядит так:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
/wp-admin/ закрыт целиком, но admin-ajax.php открыт явно. Через этот файл работает AJAX - технология, которая позволяет странице подгружать данные без полной перезагрузки (так устроены, например, живой поиск по каталогу или кнопка «показать ещё»). Многие плагины и темы дёргают admin-ajax.php напрямую с фронтенда, и без доступа к нему боты могут не суметь корректно отрендерить часть страницы.
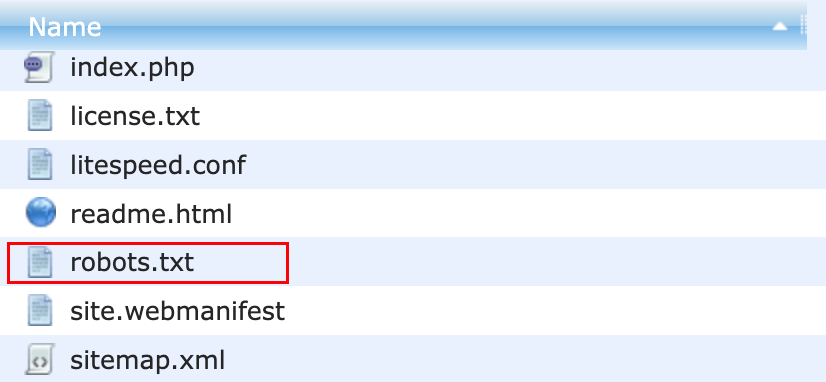
Так выглядит физический файл в файловом менеджере хостинга - в корне сайта, рядом с index.php и sitemap.xml, а не внутри wp-content или wp-includes:
В разделе «Настройки → Чтение» есть галочка «Попросить поисковые системы не индексировать сайт». Начиная с WordPress 5.3 она добавляет в код всех страниц метатег <meta name='robots' content='noindex,nofollow'>: сайт целиком выпадает из поиска, хотя сам robots.txt при этом не меняется. В версиях до 5.2 включительно та же галочка переписывала виртуальный robots.txt на Disallow: /. Опция часто остаётся включённой после переноса с тестового домена на боевой, и владелец узнаёт об этом только когда трафик из поиска обнуляется.
Что происходит, если создать свой файл
Схема повторяется раз за разом. На сервере остаётся физический robots.txt - от старой версии сайта, от переноса, от ручного эксперимента через FTP. Дальше все правки через Yoast SEO (Инструменты → Редактор файлов) или Rank Math (General Settings → Edit robots.txt) просто не применяются. Оба плагина честно показывают форму редактирования, сохранение отрабатывает без ошибки, но на сайте остаётся старый физический файл, потому что он и есть тот файл, который отдаёт сервер.
Та же проблема вылезает у кеширующих плагинов по другой причине: правки в SEO-плагине сохранились корректно, но кеш страниц отдаёт устаревшую версию /robots.txt, пока кеш не очищен вручную.
Проверить, какой сценарий у вас, просто: если через FTP или файловый менеджер хостинга в корне сайта виден файл robots.txt рядом с wp-config.php, он физический и побеждает всё остальное. Если файла нет, работает виртуальная генерация, и правки через плагин применяются сразу.
Проверить это можно и без FTP - за один запуск бесплатной проверки домена.
WHOIS и возраст домена, CMS, SSL, SEO-теги, DNS, хостинг, чёрные списки и проверка по 152-ФЗ - на одной странице, без регистрации.
Запустить проверку →Какие директивы реально понимают Google и Яндекс
Официальная спецификация Google прямо говорит: «other fields such as crawl-delay aren't supported» - если в robots.txt когда-то писали Crawl-delay: 10, рассчитывая придержать Googlebot, это никогда не работало. Та же директива у Яндекса отменена официально и с точной датой: «From February 22, 2018, Yandex doesn't take into account the Crawl-delay directive». Управлять скоростью обхода сейчас можно только через настройки в Search Console и раздел «Скорость обхода» в Яндекс.Вебмастере, не через файл.
| Директива | Яндекс | |
|---|---|---|
| User-agent | поддерживается | поддерживается |
| Disallow | поддерживается | поддерживается |
| Allow | поддерживается | поддерживается |
| Sitemap | поддерживается | поддерживается |
| Clean-param - убирает из индекса дубли с параметрами в URL, вроде utm-меток | не поддерживается | поддерживается |
| Crawl-delay | не поддерживается | не учитывается с 2018 года |
| Host | никогда не поддерживался | отменена (данные независимых источников - около 2018 года) |
Директиву Host из старых шаблонов для WordPress пора убирать - актуальный официальный список поддерживаемых Яндексом директив её уже не включает. При конфликте правил Google берёт менее ограничивающее правило, если пути совпадают по длине, и более точное (длинное) правило, если длина разная - конкретный путь побеждает общий.
Три мифа про robots.txt, которые пора забыть
Миф 1: AMP-страницы нужно отдельно открывать для Google. AMP (Accelerated Mobile Pages) - облегчённый формат мобильных страниц, который Google продвигал с середины 2010-х как способ ускорить загрузку. Преимущество для карусели новостей отменили ещё в 2021 году. Актуальная официальная инструкция Google сегодня посвящена тому, как AMP-страницы убрать из поиска, если они больше не нужны - сам факт существования такой инструкции в 2026 году показывает, что приоритет с формата снят давно. AMP-страницы индексируются как обычный HTML, никакого специального доступа в robots.txt они не требуют.
Миф 2: RSS-ленту нужно держать открытой для Яндекса и закрытой для остальных. Официального источника с такой рекомендацией нет ни у Google, ни у Яндекса. Правило встречается только во вторичных SEO-блогах без ссылки на первоисточник - похоже на пережиток эпохи, когда фид использовался для импорта в сервисы, которые сегодня не играют прежней роли. Открытие или закрытие фида заметного эффекта на позиции не даёт ни у одного из поисковиков.
Миф 3: Disallow убирает страницу из поиска. Уже разобрано выше: robots.txt регулирует обход, не индексацию. Страница может остаться в выдаче даже будучи закрытой в robots.txt, если она уже была проиндексирована раньше.
Как настроить robots.txt для WordPress: пример
Рабочий пример, который закрывает реальные служебные разделы и не трогает ничего лишнего:
User-agent: *
Disallow: /wp-admin/
Disallow: /wp-includes/
Disallow: /wp-login.php
Disallow: /xmlrpc.php
Disallow: /?s=
Disallow: /search/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://вашсайт.ru/sitemap.xml
Что здесь и почему:
/wp-admin/,/wp-login.php- админка и вход, ботам там делать нечего/wp-includes/- системные файлы ядра, не для индексации/xmlrpc.php- старый интерфейс удалённого управления, часто цель атак ботов, для обычных посетителей не нужен/?s=и/search/- результаты внутреннего поиска, дублирующийся и бесполезный для чужого поиска контентadmin-ajax.phpоткрыт явно, иначе часть интерактивных элементов может отрендериться некорректно
Не блокируйте /wp-content/themes/ или папки с JS целиком - там лежат CSS и скрипты, без которых Google не сможет нормально отрендерить страницу и оценит её как визуально неполную. Это старая ошибка из шаблонов 2012-2015 годов, которая до сих пор кочует по гайдам.
Собрать такой файл с нуля можно генератором robots.txt - в нём есть пресет под WordPress, отдельные правила для ИИ-ботов и автоматическая строка Sitemap.
Нужно ли блокировать ИИ-ботов
Отраслевая практика делит ИИ-краулеров на две группы:
- Тренировочные - GPTBot, CCBot, ClaudeBot, Bytespider, Google-Extended. Собирают контент для обучения моделей.
- Поисково-ответные - OAI-SearchBot, PerplexityBot, Claude-SearchBot, Claude-User. Заходят по конкретному запросу пользователя, ближе к обычному поисковому боту.
Если не хотите, чтобы текст сайта уходил в обучающие датасеты, закрывайте первую группу. Если важно оставаться видимым в ответах ИИ-ассистентов, вторую группу лучше не трогать.
Есть техническая деталь, которая ловит по инерции: старые строки user-agent Claude-Web и anthropic-ai больше не активны. Правило, написанное под них, ничего не блокирует у текущего ClaudeBot Anthropic - имя изменилось, а старые шаблоны эту замену не всегда учитывают. Ядро WordPress не умеет управлять ИИ-ботами само - это либо сторонний плагин, либо ручное правило в robots.txt.
Частые ошибки и как их найти
- Забытая галочка «Попросить поисковые системы не индексировать сайт». Разобрана выше - остаётся включённой после переноса с тестового домена и закрывает от индексации весь сайт.
- Физический файл против плагина. Тоже разобран - правки через Yoast/Rank Math не действуют, пока в корне лежит старый физический файл.
- Кеш отдаёт старую версию. Правки сохранены, но кеширующий плагин показывает предыдущий файл, пока кеш не очищен.
- robots.txt недоступен для бота. Search Console репортит «robots.txt unreachable», хотя файл физически на месте - причина обычно в блокировке на уровне хостинга, файрвола или CDN, из-за которой бот вместо кода 200 получает ошибку или таймаут. Google в этом случае консервативно считает сайт временно закрытым целиком.
- Плагин защиты блокирует лишнее. Некоторые плагины защиты от скрейперов добавляют
Disallow: /wp-content/uploads/по умолчанию - правило написано по пути, без разбора конкретного бота, и заодно закрывает изображения от Google Картинок.
Общий технический аудит сайта - не только robots.txt, но и битые ссылки, дубли title, пустые описания - можно прогнать краулером.
Как проверить свой robots.txt
- Откройте тестер robots.txt
- Вставьте текущее содержимое вашего файла
- Укажите путь, который должен остаться открытым - например, адрес главной статьи блога
- Выберите робота и проверьте результат
- Повторите для путей, которые должны быть закрыты -
/wp-admin/, результаты поиска
Если инструмент показывает блокировку там, где её быть не должно, в файле лишний Disallow выше по списку, который перекрывает более узкое правило.
вашсайт.ru/robots.txt всё равно откроется - WordPress генерирует его на лету. Физический файл, если он есть, лежит в корне сайта рядом с wp-config.php и папками wp-admin, wp-content, wp-includes.noindex в коде страницы или HTTP-заголовок X-Robots-Tag.Источники
- WordPress Developer Resources, «do_robots()», обновлено 20.08.2026, https://developer.wordpress.org/reference/functions/do_robots/
- Google Search Central, «How Google Interprets the robots.txt Specification», обновлено 2026-08-31, https://developers.google.com/crawling/docs/robots-txt/robots-txt-spec
- Google Search Central, «How To Remove your AMP Pages From Search», обновлено 2026-07-01, https://developers.google.com/search/docs/crawling-indexing/amp/remove-amp
- Search Engine Journal, «Google Updates Robots.txt Policy: Unsupported Fields Are Ignored», 07.10.2024, https://www.searchenginejournal.com/google-updates-robots-txt-policy-unsupported-fields-are-ignored/529400/
- Яндекс, «Использование robots.txt», https://yandex.ru/support/webmaster/ru/controlling-robot/robots-txt
- Яндекс, «The Crawl-delay directive», https://yandex.com/support/webmaster/en/robot-workings/crawl-delay.html
- Yoast, «File editor robots.txt», https://yoast.com/features/file-editor-robots-txt/
- WordPress.org Support, «Site blocked by robots.txt but I cannot find where», https://wordpress.org/support/topic/site-blocked-by-robots-txt-but-i-cannot-find-where/
- WordPress.org Support, «Failed: Robots.txt unreachable», https://wordpress.org/support/topic/failed-robots-txt-unreachable/
- TechnologyChecker.io, отчёт о блокировке ИИ-краулеров, сентябрь 2026, https://technologychecker.io/blog/robots-txt-ai-crawlers-blocking-report
Проверьте техническую сторону своего сайта за один запуск - без регистрации и без установки чего-либо.
WHOIS и возраст домена, CMS, SSL, SEO-теги, DNS, хостинг, чёрные списки и проверка по 152-ФЗ - на одной странице, без регистрации.
Запустить проверку →